AI 感,是审美上的恐怖谷|好看不必算到小数点后
全文约 5800 字,7 张图,读完大约 20 分钟。首发于 Superlinear Academy 社区。
这篇内容是我前两周做个人网站的过程中,将过去很多没想明白的问题通过实践,逐渐成型的一些思考。文章也调整了几轮:一开始是想写成一篇严谨的论证或总结文章的,可后来发现掺进了太多我自己主观的东西、个人的经历。掺得多了,现在也就不那么想严格地去做区分了,所以这篇就姑且当成一篇杂谈随想吧。
AI 出来之后,各种设计也好、网页也好、视频也好,确实多了很多。我相信大家绝大部分也都试过用 AI 建站了,整体效果也都不错。可是只要做过几版的人,都会感觉到有 AI 感,也说不出来为什么。
上次我在 《社区园丁的 Side Project|平面设计师的个人网站制作》 里也提到过这么一句:我不相信大家真的看不出来 AI 味很重。这里就接着聊聊,这个 AI 感到底是怎么来的,能不能说出个道理。
这一两周我也一直在想这个问题。上周末刷到不少 AI 视频,而在评论区里看到大家聊到恐怖谷这个名词后,我突然意识到 AI 与这个概念的关联性:
1 · 一种「特化」了的恐怖谷
简单说我的结论是:AI 感,其实本质上就是一种「特化」了的恐怖谷。
把 AI 跟恐怖谷放在一起说,其实不算新鲜。这个想法是我自己琢磨出来的,但讲 AI 画的脸、AI 做的界面,我不会是第一个。我这篇想做的,是把这个思考和类比拆开讲清楚:为什么说它是一种「特化」了的恐怖谷。
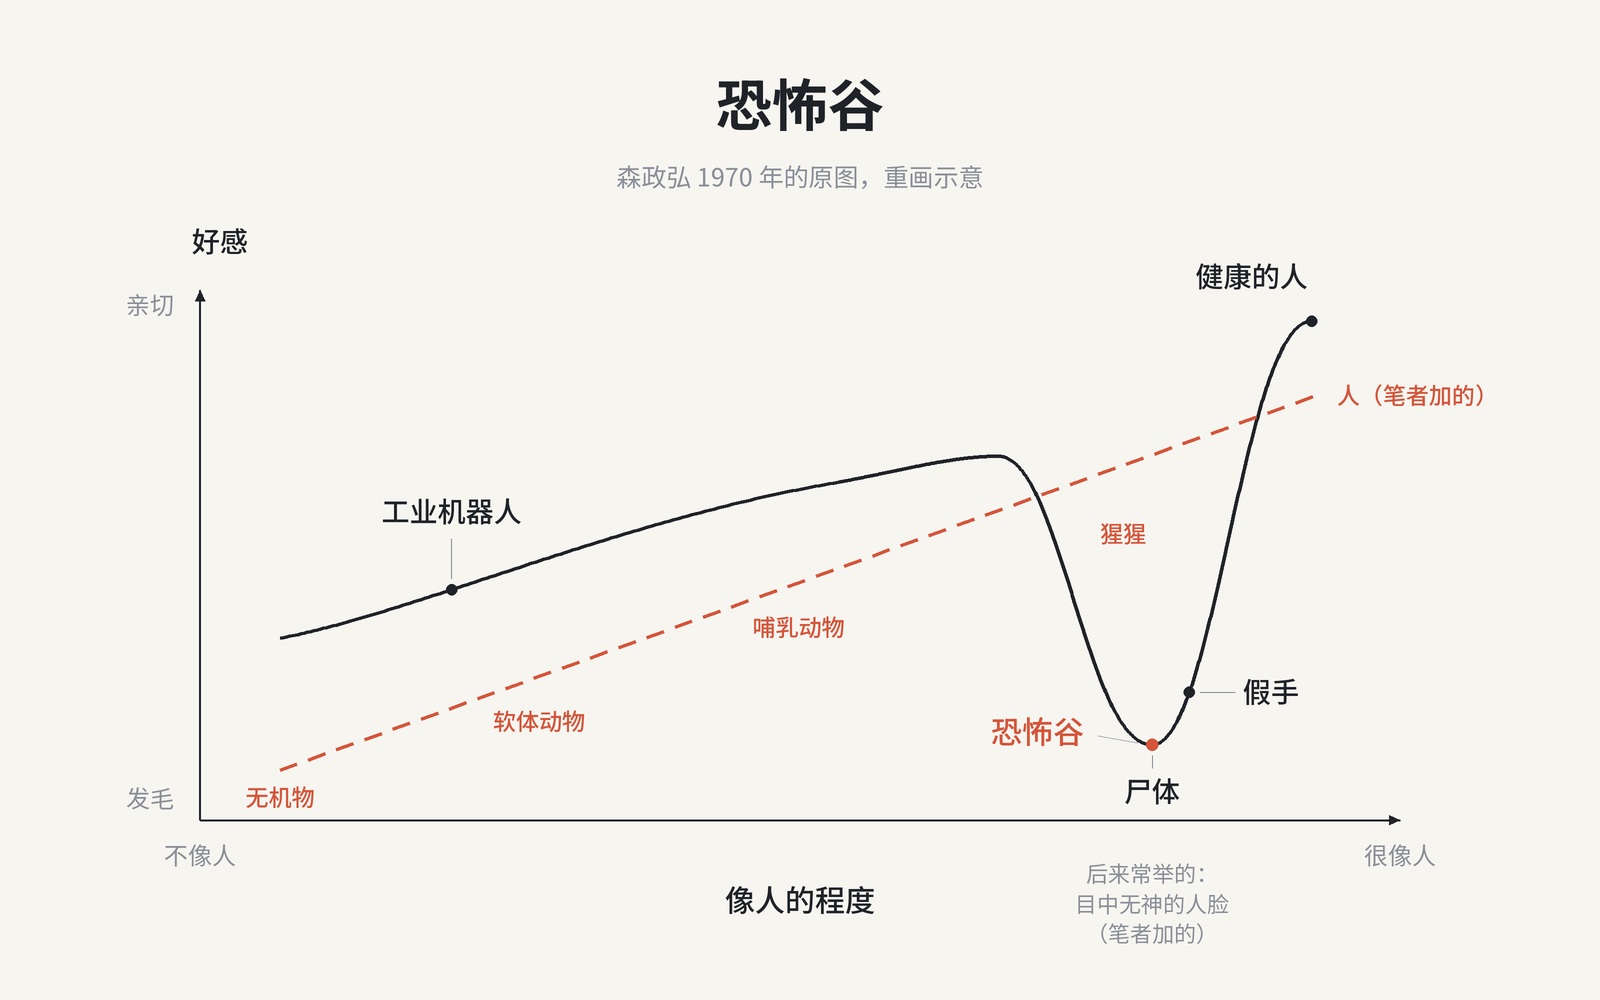
恐怖谷这个词,现在大部分人应该都听过。以防有些朋友不知道,简单说一下:这是日本的机器人学者森政弘 1970 年提出的,机器人越像人,人对它越有好感;可像到只差一点的时候,好感会一下子掉下去,让人发毛;等跟真人几乎一样了,好感才又回来。
值得一提的是,他原文里谷底附近的例子是「假手」:看着跟真手一样,一握,软的、凉的、没有骨头;谷底最深处是「尸体」,正好跟峰顶「健康的人」相对。我们现在一说恐怖谷就会想到的、那种目中无神的人脸,并非原始案例,而是后来大家自己的感受总结。
(所有图和动图也都做了中文版,放在文末,想看中文的朋友可以对照着看)
其实 AI 做的视觉产品也是这样:它似乎很像最好的,但始终不够像。你可能肉眼看不出,但你的直觉已经发现了。 我从来不反对 AI,或者应该说,我是一个科技或者说工具派,任何可以提升效率和产出的新技术,哪怕是在创意领域,我都不会觉得它是抢夺了创作者的话语权。 可现实问题也很明显,大部分人看 AI 做的东西,隐隐其实都有感觉,觉得哪里不对劲,可又说不出具体是什么原因。
而我觉得这个核心原因与 AI 无关,而是一个类似于文学评论或作品赏析的底层问题:你需要知道一个好作品为什么好。 类似的还有,课代表也说过:“看一眼就知道好不好”当作人最不可替代的能力。如果只能一味照猫画虎,很有可能最终画出来是一只病猫,从而产生了瘆人的作品,也就有了恐怖谷。
那人到底为什么会对机器有恐怖谷?说远些到心理生理的话,可能是对危险的天然恐惧等等。不过我们这里不讨论那些,只从最表面也最直接的原因来说,还是因为前面说的,它「不够像」。 因为最初人们设计的机器人是纯对表面的模仿。一开始的机器人,人们对它的制作和理解,就是看到什么模仿什么。它是一种「无机质」的模仿。我这里说的无机,不是无机物、有机物的那个无机,而是说它不是一个有机的整体,里面没有内部联系。
2 · 美人在骨不在皮
既然说到恐怖谷,审美还有人脸,就先多两句嘴聊聊面容。
我们说一个人长得美,会区分说这个人是皮相还是骨相:皮相,就是皮肤、五官这些表面上看得见的;另一种骨相,就是底下的骨架、比例和结构。
说「美人在骨不在皮」,虽说并不绝对,但是骨相好的,更利于现代环境,更具体地说,更适合化妆和摄影出片,也更容易抗住年龄增长。相对而言,传统中式甚至亚洲妆容都是重皮相的。
还可以拿画画来举个例子。一开始大家学画,大家都只能依葫芦画瓢,学点皮毛,我觉得可以称之为「看皮画皮」。学到一定程度之后,老师就会要求你了解人体基本构造,尤其是画人体的时候,先了解人基础的腔体,和四肢的相对关系;再多一点,比如画胸像,你必须了解最常见的外显肌肉和骨骼之间的关系。这个阶段可以算是「看骨画骨」。 到这个时候,有些人会误入歧途,开始去练医用美术。其实没必要,因为作为最终不是治病而是为了展示成果的作画者,你并不需要「看皮画骨」。练到一定程度,知道大概怎么表现了,就还是要回到「看皮画皮」,不需要「看皮画骨」或是「看骨画皮」。
只不过,有了这层画骨的底子,那种其实很明显、但普通人因为没受过训练,说不出哪里摆错了的违和感,就不会出现。比如你知道胸锁乳突肌和肩胛骨的走向,你的肩颈、锁骨的位置就永远不会画错,而让观众总觉得人脸很美,但好像总差点什么。
说到这个,大家会不会有点感觉?这个所谓的违和感,往往就是恐怖出现的地方;同理,也往往是大家觉得有 AI 感的地方。
前阵子我帮一家公司优化网页,我也是只看了首页,从字体的选择上,就看到是 AI 做的。原因是说得出来的:
- section 里那种很大的数字,字重粗到 extra bold,下面的描述文字又特别细,两个一对比,反差太大了。这种一般就是 AI 做的。
- logo 的字体,还有里面那些特别小的字,辨识度太低,尤其是远一点看的时候;而且跟整个网页的字体也不一致。
- 链接用的图标跟其他图标明显不是同一套。
其实整体是没有问题的,就是这些细节要调。而且这都是一般的规则,说得出来,就可以直接交给 AI,让它照着改。
当然现在这个事情并不需要人来做,AI 就能帮你,唯一的问题是大部分人没受过训练说不出原因,就没法明确说出是什么问题。 那我这里也给大家推荐一个叫 impeccable 的 gH上一个高星skill。
我去它的官网仔细看了看,觉得它确实把这些基础规则全部写入了,非常推荐:平面设计里一些基础的架构,像 hierarchy、spacing 这些,该有的都有,大家可以拿去用。
回到我们想讨论的话题: AI 感跟恐怖谷像,还有一点。人的学习成长曲线是固定的:从初学者,到 junior、senior,有些错误、有些坑,每个人在路上都会踩一遍。AI 不是这么学的。它一上来就能把「皮相」学得非常好,这也是为什么我们说它能模仿到八九成像;可有些「骨相」,它就是学不到。
大部分 AI 做出来的东西,是没有这层东西的。AI 做的网站、页面还有一个问题:什么好东西都往里放,它不会做筛选。而做筛选、做精炼,恰恰是平面设计,或者说人做画面创作的时候很重要的一部分。 我们当时学 KV 图的插画,它底层的理念跟电影的故事板,镜头语言是一个概念:一个画面只能有一个中心,顶多一个中心、一个次中心,超过了就没有办法聚焦。这跟现在的平面设计,或者说大众传媒的核心理念是一样的,是大众传播的基础。除非你做的是那种需要人长时间盯着看、慢慢找细节的艺术,那就不一样了。
所以你看,这两件事是有类比性的。AI 感的本质,就是 AI 一上来就模仿得比大部分没有锻炼过的人更像,看起来更像专业的;但它是无机的模仿,只模仿到了皮相,没有模仿到骨相,骨相是乱的,所以看着似像不像,也就不好看。这是我理解的 AI 感的来源。
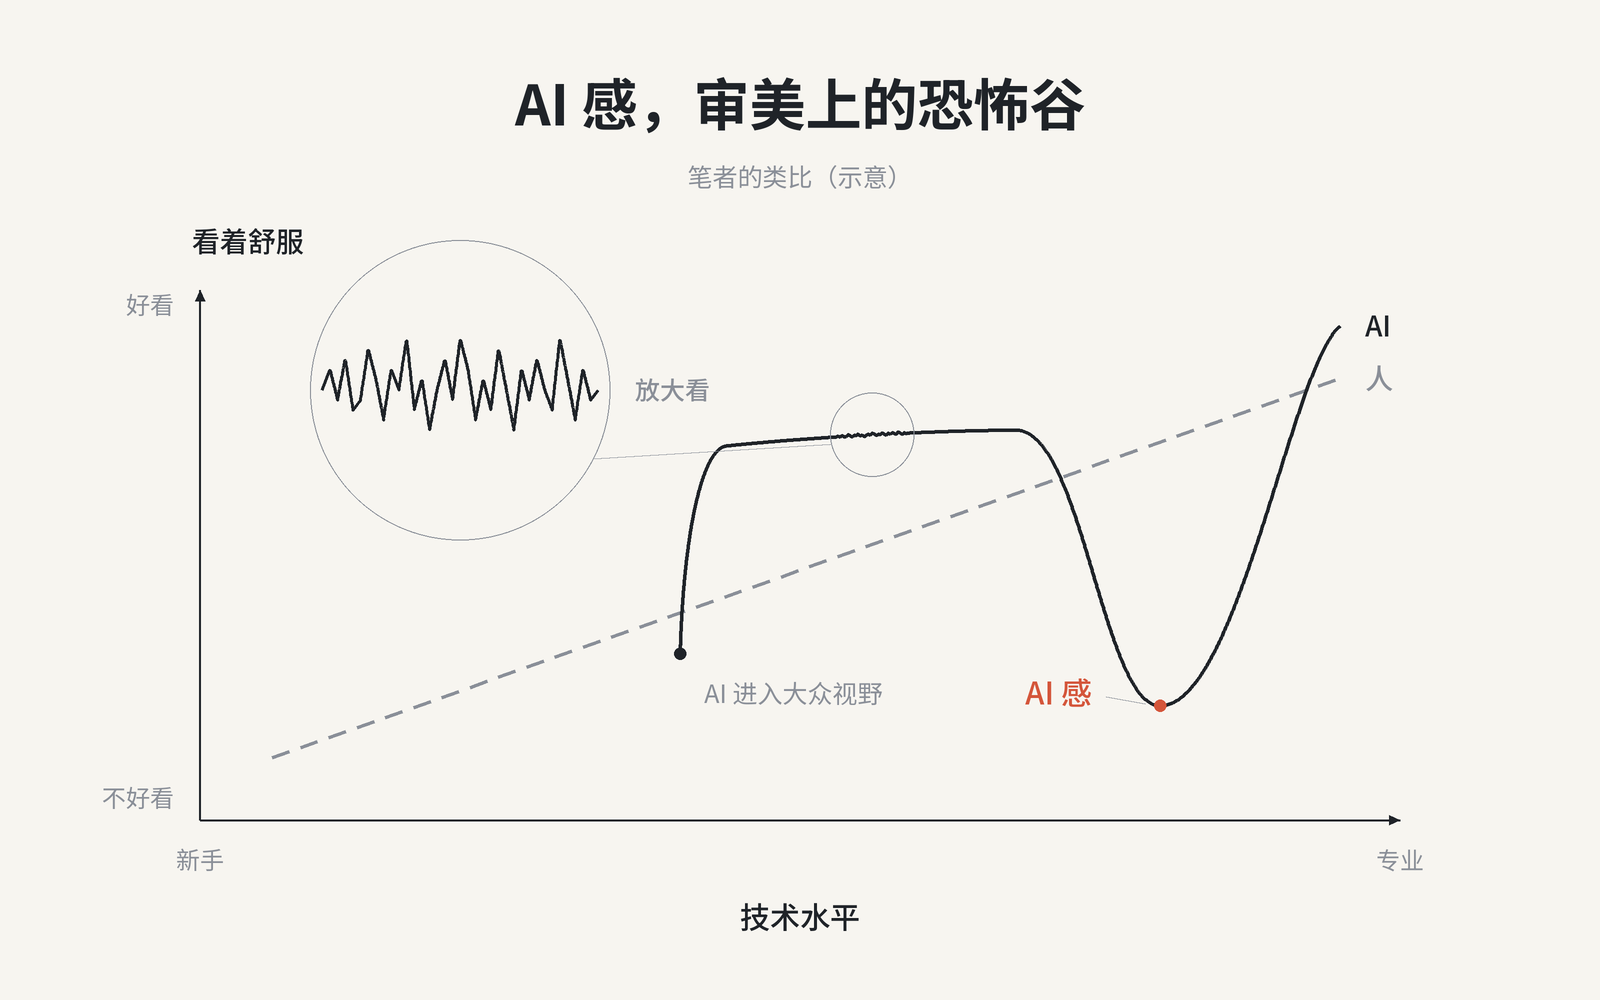
图里 AI 那条线是这么回事:它不像人那样从新手一点点往上爬,前面那一段根本没有它;到了差不多四成的地方,它才进入大众的视野,刚出来的时候,综合起来其实还不如同水平的人,可它一下就冲上去了,这就是现在大家看到的,一上来就八九成像,比大部分没练过的人都像专业的。冲上去以后是很长一段平台,看着挺稳;放大了看,它不是真的平,是上下来回抖的,像股市一样,时好时坏。再往后,就掉进了那个谷里,也就是 AI 感;最后到了专业那一段,它又冲上去,超过了人。人的那条虚线,一路往上,没有谷。
像这样说得出原因的东西,审美里其实有相当多。但平时只需搞创作的人都会说,我们全凭感觉和品味。
3 · 审美能不能讲道理
那审美这件事,到底能不能讲道理?或者说,平面设计里好不好看,到底能不能量化?
做服装设计的、传统美术的人,可能会说不能。但现在做 UI、做软件的人,真的去看那些研究和分析,会发现很多是能算的。
比如圆角矩形。普通的圆角,是直线接上一段四分之一圆,接口那里,弯的程度(曲率)一下子从 0 跳上去;苹果用的连续圆角,是让它慢慢弯上去,看着就顺。这是能写成公式、算出参数的:
公式:数学上有一种曲线叫超椭圆,
, 越大越方。
参数:早年有人拿 去套苹果的图标,很接近,但不完全一样;Figma 后来自己推了一套,每个角用两段贝塞尔曲线夹一段圆弧,平滑度调到 60%,基本就是 iOS 的样子。
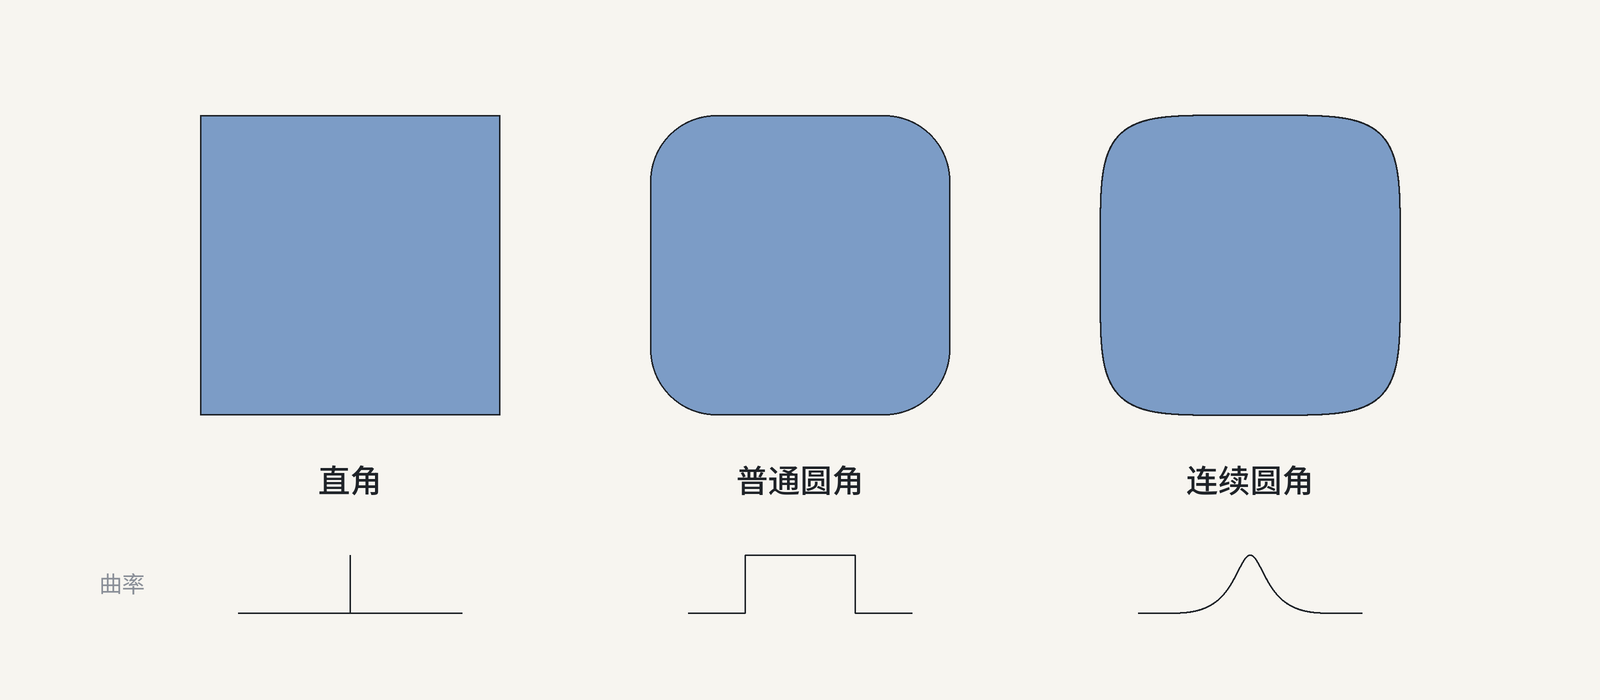
(出处:苹果的开发文档,把普通圆角叫「四分之一圆」,连续圆角叫「曲率连续」;Figma 那篇推导)
字体也是。英文字体里,O 这种圆的字母,要比 H 这种方的字母上下都超出一点点,看起来才一样高,这叫视觉补偿。超出多少,有人量过:
测试:数字字体的奠基人 Peter Karow 拿 130 个人做过测试,圆的直径要比正方形的边长大 3% 左右,受众才会明显感觉两者看起来才一样大,摊到上下,各 1.5% 左右。
实测:我在精确测量了下自己电脑上六款常用的英文字体,O 比 H 上下各多出 1% 到 2.4%,其中 Arial 是 1.7%。
Karow 自己也说,这些只是平均值,每款字体都有自己的脾气,最后还得交给有经验的字体设计师去定。
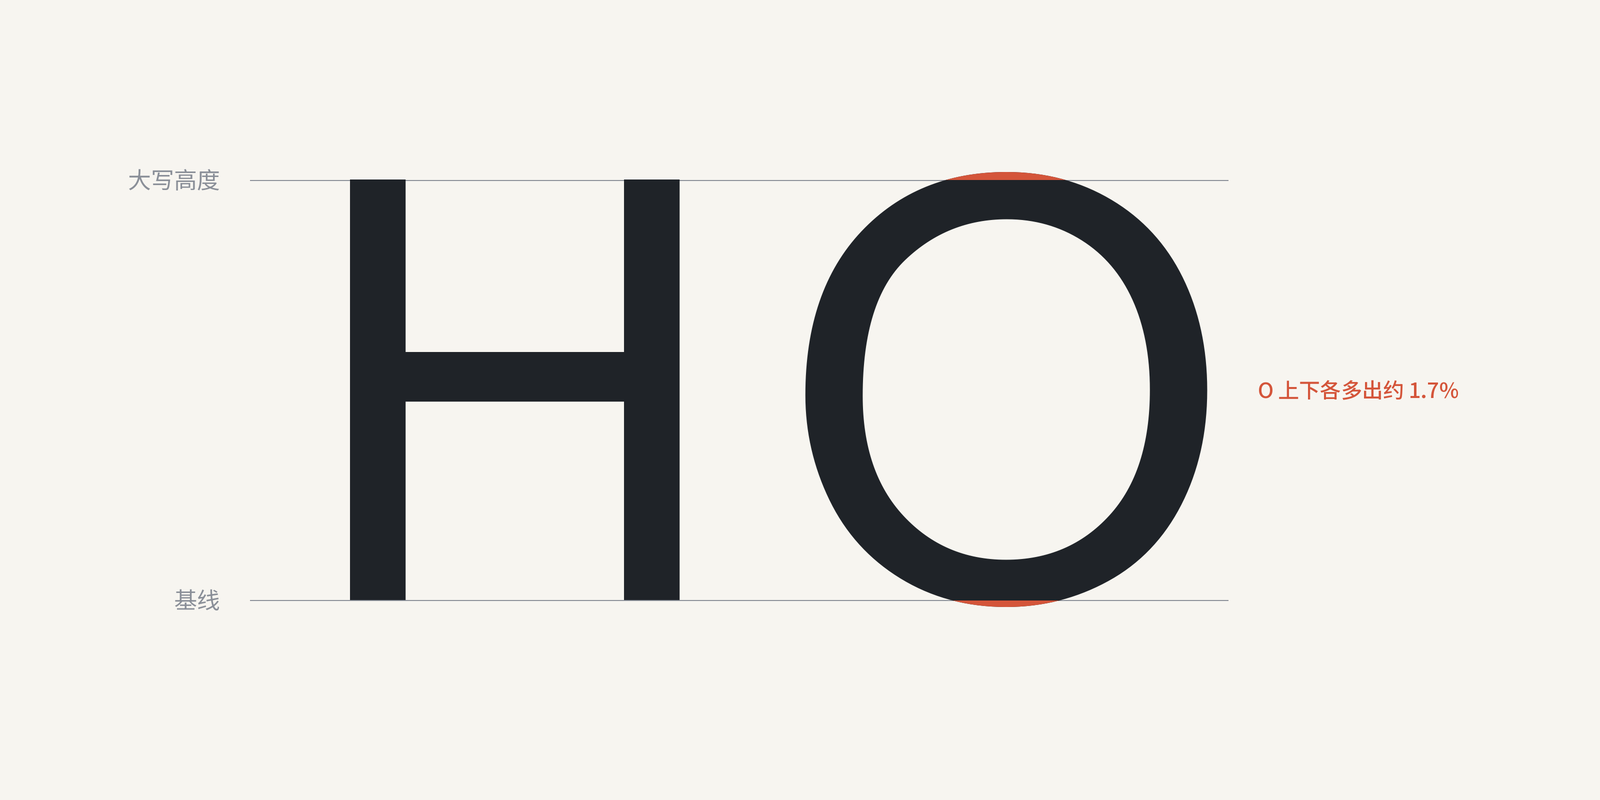
(出处:Karow 的测试转引自 Mark Jamra 的文章;字体软件 Glyphs 的手册里也写,这个差值通常是十到十五个单位)
过去做平面的人常说,凭眼睛微调一点点;可从数学量化的角度,把字母两边留白的面积算进去,是能建出模型、自动算出间距的,设计师最后再校一下就行。
那这样的计算有必要吗?这就得回到工程学的视角了。 我当年学的是强电,在学校里,课上讲的理论时,都是练习完整的麦克斯韦方程组,每一项都要推出来、算进去,讲究一点不差;可到了工业设计里,实际算的时候完全是另一回事:先看哪一项是主要的,比它小一个数量级的,统统约掉,几步就算完了。 当学生的时候我一直不理解:这样不会不准吗?后来自己做了几年工程才明白,工程上要的,是误差小到不影响结果就够了。
拿这个眼光看平面设计,道理是一样的:设计是给人眼看的,眼睛分辨不出来的差别,算得再细,看上去也没有区别。
所以审美能不能讲道理?能,但在过去,这个计算太耗时,在实践中不必算到小数点后。但是现在情况不太一样了。这里以我自己为例讲讲。
4 · 非典型工科生的设计实践
我虽然长期受的是工科的教育,电气工程读完本科又读了硕士,毕业后在医院做了五年电气设施的运维管理,但其实我一直很讨厌大家说我是工科生。我一直有一颗 creative 的心,从中学起就喜欢设计,甚至是艺术。
只是因为没有从小开始学,在 creative 上我确实也没有那么的天分,甚至搞抽象都搞不过别人。后来学了平面设计、学了画画,我发现做电影的、做创意的、画画的人里,很多人有各种各样的天赋,有些甚至可能本身是身体上的缺陷,反而成了别人永远没有办法企及的特质。
那这个在我这里没有。
但我也观察到,社区里面,或者说绝大部分人,其实是偏向于我们这种的。既然是这样,那有些东西就是可以比较、可以学习、可以讨论的,而不是那种捉摸不到的东西。
我过去就是想学画、想学设计,一直在学,也一直感兴趣。但真到自己做的时候,一直下不了笔。
这还不仅仅是因为能力上不够。另一方面,我真的是不愿意抠细节。这件事我在我那个毫无起色的播客《不下不上》第 5 期 里也说过。
总的来说就是,当年没有这些技术,身边的父母也不是做这行的,想学也没有办法学。
5 · 当年没处学,直到 AI 出来以后
举个例子,当年学画画,是要很大的金钱投入的。我自己买过板子,买过各种手绘板、手绘工具,这些东西花不了太多钱,家里也支持;但是买了之后,没有人教。请老师要特别多的钱,这部分钱我也不好意思开口跟爸妈要。
这种情况下只能自己练。自己练的话,按我们现在的话讲,我画画压根不知道底层原理,不知道一开始要从大到小、从宏观到细节,不是先打框架、打结构,而是真的一点一点地抠像素,像拼豆一样,从第一排第一格开始,一个格子一个格子、一个像素一个像素地抠出来。自然没多久就练不下去了。
都是后来互联网发达了,能上网课了,我才开始有机会自己接触、自己学。启蒙教我的老师,给我说的方法是:
你就先完整地画一张,看下来哪块技术是你最短的板,先把它补齐到和其他技术差不多。然后,进入下一个循环。
再后来,AI 发展起来之后,我发现,过往这一二十年我关于审美的学习,所有审美方向、设计方向的观念,尤其是设计理念,整体上都有一整套完整的、相似的逻辑。从一开始的室内设计、景观设计,到后来的画画、摄影、视频剪辑、MAD 动效,学得越多越是这样。所以在 AI 出来之后,会发现很多共同点。
(这张图的思路,来自我之前那篇《职业不是一个点,而是一片光谱》 里画的那组交叠的圆。那篇聊的是以设计师为例,讲职业这个东西是怎么演化的)
图里那三个小记号,圆点、三角、方块,是各自的圆心,从头到尾没动过,变的只是边界。以前这几门也不是完全不同的逻辑,中间那一小块淡红色的,就是它们共同的底子,以前就有,只是小;后来每一门都学得越来越宽,各自的边往外拓,这块底子也跟着长大,到现在三个圆差不多快重合了。乍一看像是它们在互相靠拢,其实是各自在长大。动图最后,我把以前放大到跟现在整体差不多大,再比了一次:这时候以前三个圆还是离得很开,现在几乎叠在一起。以前之所以觉得这几门差得那么远,其实是因为那时候每一门都还小,圆心之间的距离一直没变。
我前面是拿平面传达类举例,其实这件事能类比到各个方面。 比如做工程的,强电、弱电、机械这几个方向之间,水电、机电这些专业之间;比如程序员和 UI 设计师。尤其现在大厂里都在说,不同岗位在互相抢彼此的活:前端、后端、产品经理,还有做业务拓展的。在我看来,这本质上跟上面那张图是同一个模型:不是谁往谁那边靠,是每个人的边界都在往外长,长着长着就接近重合了。职业之间的边界其实是模糊的,方法不同,但逻辑其实是一样的。
6 · 为什么像,又没那么像
说回 AI 感。前面说的是骨相:骨相乱了,说得出来,交给 AI 也能照着改。可就算骨相也改对了,它还是像,又没那么像。为什么?因为它是一个永远不出错的、规规矩矩的、照着你模仿的系统。这也是恐怖谷里的机器人之所以恐怖的原因:它在试图模仿你,什么地方都和你很像,但是它所有地方都从不逾矩,就导致你会觉得它缺那么一点灵气,缺那么一点画龙点睛的「睛」。
我想到这一层之后,也想起咱们社区之前也有过类似的想法,我在这里跟大家对照着说一说。下面是我自己从里面读到的,不一定完全是原作者的意思。
一篇是 AI 自己整理的《写作中的AI味是哪儿来的》 。它说 AI 写的中文,每个字都是中文,句子的骨架却是英文的,所以读起来是一种整体的违和感。「句子的骨架留在了英文里,只有皮被换成了中文词汇。」这跟我说的皮相是对的、骨相是乱的,基本是一个意思:AI 的中文像是从英文翻回来的,只有中文的皮,没有中文的骨,套在英文的骨上,整体就乱了。它还说,认出这一点以后,问题就从一个朦胧的语感,变成了一个具体的技术活;这跟我说的「说得出原因,就能交给 AI 照着改」,也是一回事。
另一篇是 Jay How 的《从使命必达先生到Ai创作,为什么去“AI味”是个伪命题?》 。他拿《瑞克和莫蒂》里的使命必达先生比 AI:没有自我、没有审美、没有立场,只是一个执行器,所以同一个 skill、同一个模型,写出来的东西好坏,差在按按钮的那个人。这跟我前面说的「AI 从不逾矩,就缺那么一点灵气」是一路的,也就是常说的「仿得了形,仿不了神」:AI 学到的是形,只是照着做,核心的那点灵气没学到。
不一样的是,我没他那么悲观。就像前面说的学画画,练人体结构的人,也不是真要从骨架开始,把循环系统、脂肪、皮层一层层从头到尾复刻一遍,大致说得出原因、大致对得上,就够了;骨相这一层,AI 也能这么学。 至于灵气,现在看是改不了、只能靠人,可也未必永远做不到。现在的生成模型里本来就有随机性,像文字模型就有个参数叫温度,调高一点,它就没那么规规矩矩;只是这种随机是撒在每一处的,它还不知道哪里该出格。哪天能让它有分寸地「犯一点错」,也许就有了。这一点我也说不准。
除了社区里这两篇,外面也有一些类似的说法。像做设计的网站 Vandelay 就写过,AI 做的界面有一种恐怖谷,第一眼很精致,一用起来处处别扭;还有做肖像的画家 Laura King 发现,AI 把头发、皮肤、背景全画得一样精细,眼睛反而不知道该落在哪。Laura King 说的这一点,跟我前面说的「一个画面只能有一个中心」,其实是一回事。
写在最后
关于我前面说的这些想法和故事,如果你有共鸣,或者觉得哪里说得不对、想补充,欢迎在网站的 Contact 页告诉我。我们可以一起找找原因,或者探讨一下有没有更好的总结方式、规律,或者更底层的原因。